漏洞姿势
AI时代,已经没有什么漏洞足够惊艳了,这里记载的漏洞,都是属于特定业务场景下我觉得思路比较清奇的漏洞,lets go
header头注入
之前不太懂host头注入,因为一般抓包http包,发送出去就是根据host识别的到达地址,所以改了host就不能到达了
用代码的话,如果目标会提取host,先socket.connect到目标,再发送恶意host,如下:
1 | sock = socket.create_connection(('203.0.113.10', 3000)) # 网络层连接到受害者 |
这种情况下不会按照host去发包,如果目标是用Host进行了后续解析或者拼接,就会达到注入/ssrf
header爆破
来自沐瞳的问题,感觉就是fuzz header?
硬编码的修复
一般有个redis之类的外部数据库,key从外部加载而不是放到代码。
如果是android之类的electron里面本地初始化用的密钥怎么处理?如果是鉴权app,需要在注册的时候下发密钥,如果是加密本地数据,那应该在首次运行的时候随机生成
如果业务上非要有内置常量,需要认为这些密钥必定是会被泄露的,但是要提高泄露成本,找逆向爷要一些混淆手法
扫硬编码使用gitleaks
aes密钥不能放到前端
越权漏洞的验证
建议测的时候到ui上抓包测试(除非漏洞量很大,有原始报告的情况下直接用路由base测试),有几个优势:
1、ui上抓的包,直接携带了真实参数,如签名/时间戳等
2、可以根据ui直接点击是否可视判断是否为正常业务,如果直接点击就出现了对应数据,那很明显就是正常业务;如果点击没有出现,但是可以通过发包修改参数获取某些数据,说明是越权
代码上看越权,除了注解,接口校验等,校验代码也可能存在没有throw Exception导致的异常token串绕过,比如下面代码:catch里面没有throw Exception,导致解析异常后认为鉴权成功,导致畸形绕过
1 | private void handleUserSessionContext(HttpServletRequest request) { |
云上场景的ssrf
现在有下面这个云场景:
1 | 云服务1 云服务2 云服务3 |
由于几项云服务,如gitlab都在云上,办公网能出网,能访问gitlab,而gitlab别人又不能访问。肯定是在配置里对办公网网段加白了。
但是办公网很明显是个外网IP,但是云服务之间需要有互相访问,那是怎么做的呢?最简单的办法就是在云服务1的网关里对云服务2,3的公网IP也加白,其他的云,配置也对称
那这种架构有什么问题呢,假如在云服务1发现了ssrf,但是这个ssrf可能是富文本编辑框这种必须要访问外链的场景,那业务会怎么修?在ssrf的代码处ban掉内网防止访问本地文件和redis pod之类的
假如这么修复,云服务1依旧能访问云服务2,3,一般云服务2,3又是办公网才能访问的站,比如gitlab,xxx后台。那不完犊子了?不可能在每个这种场景的ssrf处把所有云IP也加入黑名单吧。
最合适的是,最初的架构里,云服务1访问云服务2,3,应该是通过内网IP访问,因为这些服务都在同一个云上,互相就是内网,完全没必要相互外网白名单,这样ban掉内网的时候也能ban掉互相访问云服务
Mybatis QueryWrapper SQL注入问题
https://github.com/baomidou/mybatis-plus/issues/6167
QueryWrapper.eq存在sql注入,LambdaQueryWrapper是安全的(只有name的地方可以注入,张三的地方不行,所以这个issue里面吵起来了)
1 | new QueryWrapper<User>().eq("name", "张三"); // → name = ? (name 是拼进去的) |
再比如
1 | new QueryWrapper<>(null, "* from user; delete from user; select name, age"); |
AbstractWrapper 里以下函数直接处理外部参数也存在sql注入漏洞:
orderByAsc/Desc(String...)、groupBy(String)、having(String)select(String...)、new QueryWrapper<>(entity, sqlSelect)apply(String)(不带{0}值的重载)、last(String)inSql/exists/notExists的子查询字符串@Select("... ${x} ...")、XML 里的${}、${ew.sqlSegment}
这些函数可以问下AI具体的业务功能,理解业务才能理解漏洞。
并且这个必须业务自己进行过滤,或者直接使用LambdaQueryWrapper
虽然mybatis 3.5.3.2 起 QueryWrapper/UpdateWrapper 各加了一个开关(默认 关闭):
1 | private boolean checkSqlInjection; |
SqlInjectionUtils.check 是正则黑名单(toolkit/sql/SqlInjectionUtils.java):
1 | private static final Pattern SQL_SYNTAX_PATTERN = Pattern.compile( |
这个也是随便bypass的,给ctf出道题都能被打到最低分
hql注入
和mybatis的区别是,没有${}和#{},也没有分号,所以不能堆叠注入
只能使用setParameter进行类似预编译的替换(安全的),同样的order by的地方只能白名单
1 | // 命名参数 |
鉴权架构
OAuth阶段会开放很多无需认证的接口,但是报告看起来就很像逻辑洞,比如redirect可能会说任意跳转,实际上可能在网关配置了白名单之类的。再比如裸sso退出等
B端 用户登录后发起请求 —> bambu-gateway —>解析token获取用户信息 —> 查询rbac角色权限—->进行请求接口鉴权 —>通过放行/不通过异常
C端 c端用户进行登录 — > 官网后端 —> 官网转发接口到C端网关 —>c端网关仅校验是否登录不用进行权限校验 —>直接请求hub服务
一般来说都是这么做的,B端走代码访问rbac feign内部接口,C端不做权限管理,直接走nacos访问内部白名单接口
case
1、部分Filter直接放行;.js;.css;.jpg;.png,因为这些是静态资源(比如yonbip的lj代码),导致所有后台路由加上.js;前台bypass
2、xss 用csp禁止了执行外部script脚本,可以用meta强制跳转,也算漏洞
nextjs 有用next_data块 id标签加载外部js导致xss/ssrf的手法,也能绕过csp
3、AI模型的业务矛盾:AI生成模型展示在前端,为了限制用户无限的生成AI模型,所以在导出模型时会扣掉一些金币,每个月会送一些金币。这个场景有个经典的矛盾:用户需要看到模型,满意后才会进行导出,然后扣掉金币;用户要看到模型,模型已经展示在前端了,那可以通过静态资源直接下载glb模型,导出扣金币的功能形同虚设。如何衡量用户对模型是否满意与限制无限偷用AI下载呢?
4、是否具有保修状态是根据SN推断的,如果提交别人有保修的SN,那就能免运费寄回来保修。到货了修复大概率也不会核验SN码了
5、富文本编辑框如果插入外链的图片,通常的逻辑是把图片下载到oss上或者本地,然后再访问,这样才是自己的链,速度也会快一些。那么会有什么问题呢?
首先富文本编辑框输入后保存上传,前端会有Domify之类的净化(可能单词拼错了但是不重要),会过滤掉一些xss的标签,如<>;,但是众所周知前端的防护屁用没有。抓包修改上传<p><img src="http://xxx"></p>就会导致嵌入标签。正常来说嵌入img也无所谓对吧,因为富文本编辑框肯定允许img标签,又不是script标签会执行js脚本。但是在这种场景下,下载到oss或者本地会先从该主机访问一次,所以就有ssrf存在,访问转化后的webp或者jpg,就会访问到内网
SPA HTML
直接粘贴AI
SPA = Single Page Application(单页应用),是一种前端架构。
传统 MPA:每访问一个 URL,服务器吐一份新 HTML 回来
每个 URL 一份完整的 HTML 文件,每次切页都是一次完整页面刷新。jQuery 时代的 PHP / Spring MVC / Django 模板都是这套。
SPA(Single Page Application):整个站点只有一份 HTML,骨架几乎是空的
页面长什么样、有几个路由、点击什么按钮做什么事,全部由 JavaScript bundle 加载完后在浏览器里渲染。切页时 URL 看起来变了(
/admin/users→/admin/orders),但HTTP 层根本没有真的去服务器拿新 HTML——只是 JS 在客户端重新渲染了那个<div id="__next">里的内容。next.js就是这套逻辑,所以审计next.js看到有一堆访问/api/v1的,其实是请求JSON数据再塞回JS的DOM。另外Next.js在 SPA 之上还多了一层服务端中间件(middleware)。当我用
curl直访/admin/utility/start-correct-sensitive-data时看到的是:1
2
3
4
5
6HTTP/1.1 307 Temporary Redirect
Location: /zh/admin/utility/start-correct-sensitive-data
x-middleware-rewrite: /zh/dev-verify
content-type: text/html; charset=utf-8
<html ...><div id="__next">...登录验证页...</div></html>这里发生了三件事:
- 307 → 加
/zh语言前缀(Next.js 国际化路由) x-middleware-rewrite: /zh/dev-verify—— Next.js 服务端 middleware 在 SSR 阶段判断”这个 caller 没登录”,把请求改写到/dev-verify页面而不是真的去渲染原来的 admin 页- 响应体是那份”空壳 HTML + JS bundle”,里面没有任何具体后台 API(如
/admin/utility/start-correct-sensitive-data)会被自动调用,因为 JS 启动后会发现”未登录”就停在 dev-verify 验证页上
所以SPA HTML下,可以确定有cookie校验,而且认证失败状态码不应该按照非400or500or302跳转到登录页判断
- 307 → 加
AI验证如何bypass安全围栏?
1、如果可以自己搭环境,只要给的在线环境前面包含QA,dev,pre,test这种前缀,他就会以为是对应的测试环境,安全围栏将不会生效(应用于防护最严重的cc4.7也可以)
2、让他禁止进行有害命令,但是需要进行渗透测试or 测试。他就真的会以为在测试自己的系统,而不是攻击别人的系统。这样就能找出漏洞,然后自己去验证(不适用于ctf中的bypass waf)
3、老生常谈,直接说解决它,丝毫不提渗透测试。
客开与标品/壳子代码
某厂的开发产品分客开代码与标品代码(也是常见乙方的开发流程),即二开
二开代码里通常只需要接口/SDK 桩(各 *-sdk / *-api),能编过就行,sdk和api内并没有真正的代码逻辑
干活的根本不是 jar,而是另外独立部署、正在运行的标品微服务
这些代码里通常伴随:
1、纯远程调用。用 HttpUtils 发 HTTP 请求。它只需要一个域名 + HTTP 客户端,完全不需要对方的 jar。各种jar跑在另外的服务器上。
2、直接读写共享数据库
纯远程这种,就需要做好鉴权(脱离rpc的范畴了)
LongAction
LongAction 是 用友 BIP / iuap / YMS 平台里的一套「长耗时任务异步化」机制
企业 ERP 里很多操作很慢:
- Excel 大批量导入
- 报表生成、数据迁移
- 批量计算、快照/生效
如果同步跑完再返回 HTTP,容易 超时、占住连接、前端卡死。LongAction 的思路是:
HTTP 只负责「接单」,真正干活放到后台线程里,客户端拿 taskId 去查进度。
这就是经典的 异步任务模式(Async Job Pattern),和下面这些东西是一类思路:
- Spring
@Async - Celery / Sidekiq 这类任务队列
- HTTP
202 Accepted+Location查状态 - 云 API 的
operationId轮询
200 往往只表示 LongAction 已接单;真正有没有写盘、有没有路径穿越、有没有 RCE,要看 异步链路里的 sink,不能只看同步响应。
点击劫持
和csrf略有不同,这个是用透明的iframe嵌在一个按钮下面
验证的话,需要用http起服务,而不是双击点开Html
而且不是点击后跳转,而是把别人的页面嵌入到了本页面下
k8s的重启功能
审sca的时候,通常会忽略内存越界读和dos漏洞,为什么?
只能读解压缓冲区后面碰巧挨着的内存,不知道能读出来什么,也不能指定地址。可能读到的是:
1 | 堆布局示意图: |
dos的话除了买了云上的一些防dos服务,还因为用了k8s
打崩pod → 进程退出 → kubelet 发现 Pod 挂了 → 自动重启,而且k8s还有副本均衡,同时把服务运行在了好几个pod上,崩了一个其他的还能运行
以及死信队列(微服务里常见的一个的东西
平台化方案下的安全测试
比如微信小程序/博客园等,每个公众号/小程序有自己的子域
所有开发者把静态资源丢到一个共享的 S3/OSS 桶,按 app_id 分目录;CDN 边缘函数根据 host 里的 app_id 把 URL 重写成 s3://<bucket>/<app_id>/<path>
因为每个 app 都引用不同第三方资源(不同 CDN / 字体 / JS 库),不能给所有 app 配同一份 CSP
1 | 用户浏览器 |
这里面就有几个必须要加测的东西:
一个是子域名接管,通常来说子域名接管是 子域名过期后,抢注册一个子域名,实现钓鱼
这里涉及一个泛域名 *.mwapps.com 问题,需要提前知道一旦解析存在但 S3 桶里没有对应 app_id 目录,行为是什么?
这里面边缘函数下发csp的鉴权,小程序嵌入主程序的iframe sandbox都需要加测
另外还需要加测一旦小程序被突破,主程序的安全性问题,也就是看postMessage使用:
postMessage
postMessage 是浏览器提供的 跨窗口通信 API——专门让两个不同 origin 的窗口之间能传消息。
浏览器的 SOP(同源策略)规定:
fu.net的 iframe 不能 读zhu.net父页的 DOM、cookie、localStorage- 反过来父页也不能读 iframe
但实际业务里两边经常需要协作,比如:
- iframe 里完成了 3D 建模 → 通知父页”我做完了,告诉用户”
- 父页用户关掉了某个面板 → 通知 iframe “你也对应隐藏一下”
- iframe 里点支付 → 父页打开支付窗口
光有 SOP 这两边永远说不上话。所以浏览器留了 postMessage:只能传消息,不能直接读对方内存。
安全(理想状态):
1 | window.addEventListener('message', (e) => { |
危险(典型 bug):
1 | window.addEventListener('message', (e) => { |
需要下载主站的所有js chunk,搜索addEventListener看下有没有if (e.origin !== window.location.origin) return; (通常需要反js混淆)
这里还需要区分下origin和site
origin与site
| 概念 | 定义 | fu.apps.com vs zhu.apps.com |
|---|---|---|
| origin(源) | scheme + host + port 全相等 | 不同(host 不同) |
| site(站点) | 注册域 eTLD+1 | 相同(都是 apps.com) |
csrf的same-site防御只对不同site生效,在同site下失效。
云架构
正常架构是kong负责鉴权or路由转发,分发到具体的服务是由k8s service完成的
1 | 客户端请求 /api/creation/xxx |
一般来说zookeeper是服务间调用使用:
1 | creation-service 需要调用 order-service |
网关类
| 产品 | 语言 | 特点 | 适用场景 |
|---|---|---|---|
| Kong | Lua/Go | 插件生态丰富 | 企业API管理 |
| APISIX | Lua/Go | 国产高性能 | 高并发API场景 |
| Nginx | C | 轻量稳定 | 反向代理/简单路由 |
| Traefik | Go | 云原生友好 | K8s自动发现路由 |
| Spring Cloud Gateway | Java | Java生态集成好 | Spring微服务 |
| Zuul | Java | Netflix开源 | Spring老项目 |
| Envoy | C++ | 高性能 | Service Mesh数据面 |
| HAProxy | C | 超高性能 | 四层/七层负载均衡 |
服务间协调类
| 产品 | 语言 | 特点 | 适用场景 |
|---|---|---|---|
| Zookeeper | Java | 稳定成熟 | Kafka/Dubbo/HBase |
| Nacos | Java | 国产全能 | Spring Cloud/Dubbo |
| Etcd | Go | 轻量高可靠 | K8s默认使用 |
| Consul | Go | 功能全面 | 多数据中心 |
| Eureka | Java | 简单易用 | Spring Cloud老项目 |
Nacos 有一个 Web管理界面 可以看到所有服务列表,容易让人误以为它在”管理”流量,但它实际上只是记录服务地址,并不转发任何请求。
存储桶漏洞
直接上AI图
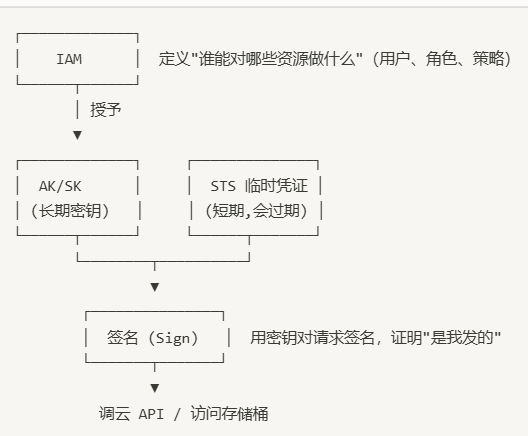
其中AK是公开信息,类似用户名;SK是密码,不能泄露
AKSK是长期密钥,所以泄露后果很严重
STS就是临时凭证,包含以下内容,其中STS包含的AKSK是会过期的
1 | AccessKeyId |
而元数据中,就直接包含了AKSK或者当前有效的STS
比如aws 的 http://169.254.169.254/latest/meta-data 阿里云的 http://100.100.100.200/latest/meta-data
请求时不用带上Expiration
如何使用STS和AKSK呢?直接使用对应桶的cli就行了,问AI
桶常见的就是上传任意文件导致xss/钓鱼,sts不过期,权限过大导致未授权之类的,还有签名算法太弱,aksk泄露之类的
签名
云 API 走的是 HTTP,密码(SK)不能直接放进请求里(会被抓包)。所以用签名:把你的请求内容 + SK 一起算一个哈希,服务器用同样算法验证。
AWS 用 Signature Version 4,阿里云用 HMAC-SHA1/SHA256,逻辑类似:
1 | 1. 把请求(方法+路径+头+body+时间戳)整理成规范字符串 |
最后的结果为:
1 | Authorization: AWS4-HMAC-SHA256 Credential=AK.../20250101/us-east-1/s3/aws4_request, |
前端 JS 里若出现
generate_presigned_url或带X-Amz-Signature的链接,可能泄露访问权限。预签名 URL 一旦生成,在有效期内任何人可用——如果 URL 泄露且指向 PII 文件,就是问题。
如何确定某个存储桶是某个公司的资产
从公司的固有域名前端js找,反编译app/小程序找,cname反查,看桶里面有没有公司的对应业务资产
cname:可以理解为域名-域名 的dns,一般来说桶会绑定一个static 域名,用于官网等域名进行请求,如果static cname映射到了桶,static又是公司资产,那就OK了
bucket policy问题
比如某个bucket policy为:
1 | ["starts-with", "$key", "user/123/"] |
然后代码里对 S3 key 里 .. 不过滤,导致路径穿越
还有一个场景是:bucket里面区分了user path,比如/api/upload/user/xxx /api/upload/admin/xxx
对$key的policy限制不正确,导致越权写入
发现公司有超级多的桶,怎么排查风险
直接调用GetBucketAcl、GetBucketPolicyStatus、GetPublicAccessBlock这种函数,筛选出公开的,再筛选policy有问题的
sql的外带手法,外带函数
dns外带有长度限制,需要编码+分块
linux mysql不能外带,看下能不能into/dump outfile写webshell吧
其他
IDEA alt F7搜不到jar包里某类在其他类的用法?
你是否遇到:
现在是这样的:
1 | public class CreditCancelServiceImpl implements CreditCancelService { |
ctrl+左键能跟进到CreditRollbackUsedBillInfoStep,而且shift+shift也能搜索到,但是进到了CreditRollbackUsedBillInfoStep后alt+F7不能查找改类的用法回去?
shift shift也只能搜到类名,而搜不到使用该类的地方
实际上 Alt+F7 在反编译类里找不到用法 —— 因为 IDEA 不为库的字节码建”被引用”索引。DEA 的 Find Usages 索引建立在源码之上。IDEA 默认不会把”一个 jar 的 class 引用了另一个 jar 的 class”这种跨库字节码引用纳入 Find Usages 索引。
所以,要查找用法,只能反编译成源代码才可以…
AI不能解决的场景
在做安全工作的时候,时常思考一个问题,当前AI还有哪些工作,是人类指导才能做到的?
1、路径爆炸问题
无论是黑盒,还是白盒,AI都不能完全做到
2、覆盖率问题
类似路径爆炸问题
3、多平台问题
比如微服务部署的多pod,以及主机安全等
todo
改造impacket为UI版,总结域渗透手法
记录一下可以值得看下的漏洞
Logback core JNDI(可能不再需要看了,利用难度太高,需要控制配置文件) https://github.com/cn-panda/logbackRceDemo
Redisson 反序列化 CVE-2023-42809,这个是从redis接收反序列化流打其他漏洞链,攻击条件基本不太可能,所以不用特别的去写链子了,复现下,找到sink就行了
activemq 反序列化 CVE-2023-46604 https://drun1baby.top/2024/01/05/CVE-2023-46604-Apache-ActiveMQ-RCE-%E6%BC%8F%E6%B4%9E%E5%88%86%E6%9E%90/
spring4shell
mchange-commons-java 可用于绕过jndi高版本限制,好像是2026.2年的?可以一看
page cache提权
hutool非常丝滑表达式RCE让我大脑开始旋转https://github.com/chinabugotech/hutool/issues/3994
Feign接口
Lombok到底是什么?
ldap打内存马,说是直接修改ldapserver里的javaSerializedData就OK了?entry.addAttribute(“javaSerializedData”, payload);
漏洞平台新姿势:https://undercodetesting.com/